Dane i AIPoradnik
Zanim kupisz AI do prognoz, sprawdź, czy bijesz proste metody
W konkursie M5 zwycięzca mylił się przy sumie sprzedaży wszystkich sklepów o 53% mniej niż automatycznie dobierane wygładzanie wykładnicze, a typowy zespół z czołowej pięćdziesiątki o 40%. Przy pojedynczym produkcie w sklepie przewaga spadała do około 3%. Zanim kupisz system prognoz, sprawdź, czy bijesz proste metody.
W tym artykule
- W skrócie
- Przy pojedynczym produkcie AI ledwo pobiło automatyczne wygładzanie
- Im bliżej pojedynczego produktu, tym mniej dokłada AI
- AI ma przewagę przy sumach, wielu indeksach i dobrych danych
- Duże korekty w dół pomagają, małe i w górę często szkodzą
- Test trzech darmowych prognoz w trzech krokach
- Kiedy test trzeba uzupełnić
- Trzy pytania do dostawcy, zanim podpiszesz umowę
- Najpierw zmierz swój proces, potem system dostawcy
- Pytania i odpowiedzi
W skrócie
Problem. Na blogu jednego z polskich dostawców przeczytasz, że AI zmniejsza błąd prognozy popytu o 20–50% względem metod statystycznych [1]. Nie dowiesz się, na jakim poziomie i na czyich danych to zmierzono.
Dlaczego. W konkursie M5 przewaga zwycięskiej metody AI nad automatycznie dobieranym wygładzaniem wykładniczym topniała z 53% przy sumie sprzedaży sklepów do 3% przy pojedynczym produkcie [2]. Korekty planistów też nie są pewnym zyskiem: poprawiają prognozę tylko w nieco ponad połowie indeksów [3].
Co zrobić. Na około 20 indeksach porównaj swoją prognozę z trzema darmowymi: naiwną (ostatnia znana sprzedaż), średnią z czterech tygodni i wygładzaniem wykładniczym, liczonymi z takim wyprzedzeniem, z jakim zamawiasz. Zmierz też korekty; z plikiem do pobrania zajmie to około godziny, gdy masz już eksport sprzedaży i dawnych prognoz.
Przy pojedynczym produkcie AI ledwo pobiło automatyczne wygładzanie
Weźmy kierownika planowania w zakładzie, który produkuje opakowania dla kilkudziesięciu klientów (to przykład, firma jest fikcyjna). Na biurku ma ofertę systemu prognoz z AI i obietnicę błędu mniejszego o jedną trzecią, a w komputerze prognozy, które jego planiści co tydzień poprawiają ręcznie. Oferta nie mówi jednego: z czym ten system porównywano.
Najlepszą wskazówkę daje konkurs prognostyczny M5. Ponad 5 tysięcy zespołów prognozowało w nim sprzedaż 3 049 produktów w 10 sklepach sieci Walmart w trzech stanach USA, na 28 dni naprzód [4]. Wygrała metoda uczenia maszynowego zbudowana z 220 modeli drzew decyzyjnych [4].
Porównaliśmy ją z wygładzaniem wykładniczym, metodą statystyczną, w której nowsze okresy ważą więcej. Organizatorzy dobierali jego odmianę, na przykład z sezonowością albo bez, automatycznie dla każdego produktu w każdym sklepie [4]. Dalej nazywamy je więc automatycznym wygładzaniem. Przy sumie sprzedaży wszystkich sklepów zwycięzca mylił się o 53% mniej niż ta metoda, a przy pojedynczym produkcie w sklepie tylko o 3,3% mniej [2].
Zanim podpiszesz umowę, sprawdź więc, czy Twoja obecna prognoza bije proste metody, które masz za darmo, i na jakim poziomie potrzebujesz lepszej prognozy. Jeśli zamawiasz indeks po indeksie, a Twoja prognoza przegrywa z prostymi metodami, więcej zyskasz na nich niż na algorytmie.
Tak wynika z danych. Przy produkcie w sklepie zwycięzca mylił się o 29,5% mniej niż prognoza naiwna, a automatyczne wygładzanie o 27% mniej [2]. Nawet najprostsze wersje wygładzania i średniej z kilku ostatnich dni myliły się tam tylko o 2–3% bardziej niż automatyczne [2]. Podobne wersje obu metod, ze stałą liczbą tygodni i stałą wagą, liczy plik do pobrania.
Im bliżej pojedynczego produktu, tym mniej dokłada AI
W średniej ze wszystkich poziomów automatyczne wygładzanie wypadło najlepiej z 24 metod porównawczych, które przygotowali organizatorzy M5 [4]. Pobiło je tylko 7,5% wszystkich zespołów [4]. Sprawdziliśmy w pliku wyników organizatorów, o ile zwycięzca pobił tę metodę na każdym z 12 poziomów danych, od sumy wszystkich sklepów po produkt w sklepie.
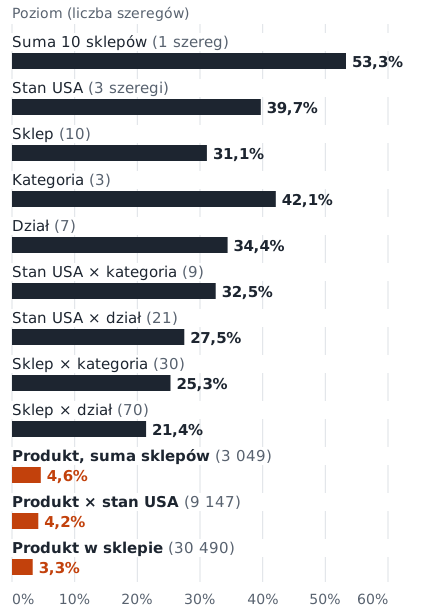
To nie wyczyn jednego zespołu: mediana 50 najlepszych zespołów to 40% przewagi przy sumie sklepów i 2,6% przy produkcie w sklepie [2].
Skąd ta różnica? Wyobraź sobie sto indeksów, z których każdego sprzedajesz średnio cztery sztuki dziennie, losowo i niezależnie od pozostałych (przykład liczbowy na danych fikcyjnych). Sprzedaż jednego indeksu waha się typowo o dwie sztuki, czyli o połowę średniej. W sumie przypadkowe skoki w górę i w dół się znoszą. Wahania rosną jak pierwiastek z liczby indeksów, więc suma stu indeksów waha się o 20 sztuk na 400, czyli tylko o 5%.
W sumie zostaje sygnał, którego model może się nauczyć: dzień tygodnia, święta, promocje i ceny. Przy jednym produkcie w jednym sklepie zostaje głównie przypadek: w M5 aż 73% takich historii sprzedaży miało popyt przerywany, z wieloma dniami bez sprzedaży [5].
Producenta najbardziej przypomina poziom produktu zsumowanego po wszystkich sklepach, bo sklepy grają tu rolę klientów, i tam zwycięzca mylił się o 4,6% mniej niż automatyczne wygładzanie [2].
U producenta działają jednak dwie siły w przeciwne strony. Dane tygodniowe są zwykle stabilniejsze niż dzienne [6], więc przypadku jest w nich mniej. Producent zwykle widzi za to zamówienia hurtowni i sieci, a nie sprzedaż w sklepach. Te zamówienia wahają się mocniej niż popyt klientów końcowych, i to tym mocniej, im dalej w górę łańcucha dostaw: to efekt byczego bicza [6]. Która siła przeważy, rozstrzygnie test na Twoich danych.
AI ma przewagę przy sumach, wielu indeksach i dobrych danych
Na poziomach od stanu USA do działu w sklepie zwycięzca M5 mylił się o 21–42% mniej niż automatyczne wygładzanie [2]. Jeśli planujesz zdolności produkcyjne dla rodziny wyrobów, zakupy surowca dla wielu wyrobów albo obsadę magazynu, zysk z lepszej metody może być duży. Spiliotis i współautorzy porównali też prognozy dziennego popytu na pojedyncze indeksy: część metod uczenia maszynowego była w nich trafniejsza od statystycznych i słabiej zawyżała albo zaniżała sprzedaż [7].
Zwycięzcy M5 korzystali jednak z tego, czego większość firm nie ma. Prawie wszystkie czołowe zespoły uczyły modele naraz na historii sprzedaży setek albo tysięcy produktów, a nie każdego produktu osobno, i używały danych o cenach, kalendarzu i wydarzeniach [4]. Firma z kilkudziesięcioma indeksami i bez danych o promocjach nie ma takiej bazy. Dane M5 pochodziły z handlu detalicznego, a autorzy zastrzegają, że wniosków nie da się uogólnić poza ten obszar [4]. Nowszych modeli, wytrenowanych wcześniej na ogromnej liczbie szeregów czasowych z różnych dziedzin (ang. time series foundation models), ten tekst nie ocenia. Każdy z nich sprawdzisz jednak tym samym testem.
Duże korekty w dół pomagają, małe i w górę często szkodzą
Robert Fildes i współpracownicy zebrali dane o ponad 60 tysiącach prognoz z czterech firm z łańcuchów dostaw [8]. W trzech z nich korekty średnio poprawiały trafność, a większe korekty pomagały bardziej niż małe. Małe często psuły prognozę [8]. Korekty w górę poprawiały ją dużo rzadziej niż te w dół i częściej szły w złą stronę: planista podnosił prognozę, choć sprzedaż wypadała poniżej prognozy systemu [8].
W 2025 r. Fildes, Goodwin i De Baets połączyli publicznie dostępne dane z sześciu badań, razem około 147 tysięcy prognoz [3]. Korekty zmniejszały błąd i odchylenie, czyli systematyczne zawyżanie albo zaniżanie, tylko w nieco ponad połowie indeksów, a wyniki różniły się między zbiorami danych [3]. Korekty w górę częściej szkodziły, a duże korekty w dół zwykle pomagały [3]. Autorzy nie znaleźli mocnych dowodów, że planiści skutecznie wykorzystują informacje niedostępne dla systemu; wyglądało raczej na to, że reagują na sygnały, które mało mówią o przyszłej sprzedaży [3].
Korekty pomagają więc tylko w części przypadków. Które pomagają w Twojej firmie, bez pomiaru nie wie nikt, także sam planista. Jeśli korekty nie wnoszą nowej informacji, sama prognoza systemu bywa lepsza od obecnego procesu [6], a pierwszy zysk leży w korektach, nie w nowym systemie.
Test trzech darmowych prognoz w trzech krokach
Wybierz około 20 indeksów na tym poziomie, na którym podejmujesz decyzję: wyroby, gdy planujesz pod zamówienia klientów, a surowce, gdy kupujesz je na wiele wyrobów. Wylosuj je z listy sprzedaży z roku przed testem, po kilka z grup A, B i C, razem z wycofanymi. Indeksy, które rzadko się sprzedają, odłóż na bok; piszemy o nich niżej.
Krok 1. Wklej dane i ustaw wyprzedzenie
Wyprzedzenie (horyzont) to liczba tygodni między chwilą prognozy a tygodniem, na który ją robisz. Weź to, z którym podejmujesz decyzję, na przykład zamawiasz surowiec albo zamrażasz plan produkcji, i wpisz je w pomarańczowe pole pliku. Wklej prognozę, którą miałeś tyle tygodni wcześniej, a nie jej ostatnią poprawkę. Jeśli system trzyma tylko ostatnią wersję, zacznij co tydzień zapisywać kopię prognoz: po kwartale zrobisz test wstępny, a po siedmiu, ośmiu miesiącach pełny.
Na zakładkę „Wiele indeksów” wklej cztery kolumny: indeks, tydzień (numer albo data), sprzedaż i swoją prognozę, indeks po indeksie, tydzień po tygodniu. Zbierz 35–52 tygodnie. Pierwsze tygodnie każdego indeksu plik zużyje na rozbieg darmowych prognoz. Jako sprzedaż bierz to, co prognozujesz: jeśli prognozujesz zamówienia klientów, wklej zamówienia, a nie wysyłki, bo wysyłki ogranicza dostępność towaru. Tydzień, w którym towaru zabrakło, zostaw z pustą sprzedażą, bo klienci kupili wtedy mniej, niż chcieli.
Przegląd stanu wiedzy zaleca porównywać każdą nową metodę co najmniej z prognozą naiwną i z popularnymi metodami, takimi jak wygładzanie wykładnicze [6]. Plik sam doda trzy darmowe prognozy: naiwną, średnią z czterech ostatnich znanych tygodni i wygładzanie wykładnicze, które daje nowszym tygodniom większą wagę. Znają one tylko tę sprzedaż, którą Ty znałeś. Jeśli prognozę na tydzień 20 robisz po zamknięciu tygodnia 14, wyprzedzenie wynosi 6, naiwna to sprzedaż z tygodnia 14, a średnia to średnia z tygodni 11–14.
Prognozę klienta albo jego harmonogram dostaw sprawdzisz w kopii pliku: wklej je zamiast swojej prognozy. Gdy ich nie bijesz, Twój proces nic nie dodaje. Przy trendzie albo sezonowości użyj też narzędzia Arkusz prognozy w Excelu (karta Dane), które liczy wygładzanie z trendem i sezonowością [9]. W „Opcjach” ustaw „Początek prognozy” przed końcem danych, a Excel policzy prognozę tylko z wcześniejszej sprzedaży [9]. Jedna data na jednym indeksie niczego jednak nie rozstrzyga: powtórz próbę dla kilku dat i tych samych indeksów, a błędy zsumuj.
Krok 2. Odczytaj wynik dla wszystkich indeksów razem
Plik liczy dla każdej prognozy średni błąd bezwzględny (MAE, mean absolute error): różnicę między prognozą a sprzedażą bez znaku, uśrednioną po tygodniach. Średniego błędu procentowego (MAPE) nie używaj przy indeksach, które miewają tygodnie bez sprzedaży, bo przy zerowej sprzedaży nie da się go policzyć [10]. Plik dzieli potem Twój błąd przez błąd prognozy naiwnej i przez błąd lepszej z dwóch pozostałych. Wynik poniżej 1 znaczy, że wygrywasz.
Plik sumuje błędy w sztukach, więc o wyniku decydują indeksy sprzedawane w największych ilościach; jeśli indeksy mają bardzo różną wartość, wpisz sprzedaż i prognozę w złotych (ilość razy koszt jednostkowy). Pokaże też odchylenie (ang. bias). Dodatnie znaczy, że prognoza systematycznie zawyża sprzedaż, a z nią zapas.
Na jednym indeksie przypadek bywa duży. W naszej symulacji na danych fikcyjnych dwie równie dobre prognozy, porównane na 26 tygodniach jednego indeksu, różniły się zwykle o mniej niż 30%, ale co dziesiąta para bardziej. Dla 20 indeksów różnej wielkości po 26 tygodni różnica była zwykle mniejsza niż 10% przy wyprzedzeniu 1–2 tygodni. Przy 3–4 tygodniach mieściła się zwykle w 15%, a przy 5–8 tygodniach w 20%; dłuższego wyprzedzenia nie sprawdzaliśmy.
Te progi plik nazywa granicą remisu i sam dobiera je do Twojego wyprzedzenia. Mniejsza próba to większy przypadek: przy 15 indeksach po 20 porównanych tygodni fałszywy werdykt wychodził nawet w co piątym porównaniu. Dlatego test po kwartale, a także test na kilku rodzinach wyrobów, plik oznaczy jako wynik wstępny.
Rozstrzyga wynik dla wszystkich indeksów razem. Liczba indeksów, w których wygrywasz, tylko go uzupełnia: przy równie dobrych prognozach wychodzi zwykle od 6 do 14 na 20. Pod wynikami plik sam wskaże wiersz tabeli. „Gorsza” i „lepsza” znaczą w niej: o więcej niż granica remisu.
| Twoja prognoza dla wszystkich indeksów razem | Co to znaczy | Co zrobić |
|---|---|---|
| Gorsza od naiwnej | Problem w procesie, nie w algorytmie | Sprawdź odchylenie i korekty, zwłaszcza małe i w górę. Z zakupem systemu poczekaj |
| Nie gorsza od naiwnej, ale gorsza od lepszej z dwóch prostych metod (średniej albo wygładzania) | Prosta metoda dałaby mniejszy błąd za darmo | Przejdź na wygładzanie (przy trendzie i sezonowości w wersji, która je uwzględnia) i mierz dalej. Z zakupem systemu poczekaj |
| Remis z prostymi metodami | Twój proces nie dodaje wartości ponad darmową prognozę | Sprawdź korekty i uprość proces. System musi w pilotażu pobić proste metody o więcej niż granica remisu |
| Lepsza od wszystkich darmowych prognoz | Proces działa | Nowy system musi w pilotażu pobić Ciebie o więcej niż granica remisu. Największe szanse ma przy setkach powiązanych indeksów i danych o cenach, promocjach i wydarzeniach |
Różnicę błędu przelicz na zapas. Zapas bezpieczeństwa wyznacza się z rozrzutu (wariancji) błędu prognozy w czasie dostawy [6]. W klasycznym wzorze to mnożnik zależny od poziomu obsługi klienta razy odchylenie standardowe tego błędu; zakładamy tu, że rośnie ono w tej samej proporcji co średni błąd. Jeśli magazyn trzyma zapas bezpieczeństwa za 1,2 mln zł, prognoza z błędem mniejszym o 10% pozwala go zmniejszyć mniej więcej o 120 tys. zł (przykład na danych fikcyjnych). To kwota jednorazowa, a licencję płacisz co roku: z jej ceną porównaj roczny koszt utrzymania tych 120 tys. zł w zapasie.
Krok 3. Zmierz wartość dodaną korekt
Na zakładkę „Korekty” wklej sprzedaż, prognozę systemu przed korektą planisty i prognozę po niej, wiersz po wierszu, także dla wielu indeksów naraz. Plik policzy wartość dodaną prognozy (forecast value added, FVA): o ile każdy krok procesu, tu korekta, zmniejsza błąd [6]. Licz osobno korekty w górę i w dół, bo te pierwsze częściej szkodzą [3]. Gdy korekty psują prognozę, zmień zasady ich robienia. Fildes i Goodwin zalecają, by planista uzasadniał każdą korektę na piśmie, a firma regularnie sprawdzała, czy korekty pomagają [11].
Jeden indeks kierownika z początku tekstu wygląda tak (dane fikcyjne, takie jak w pliku do pobrania). Sprzedaje się go około 125 sztuk tygodniowo. System liczy średnią z czterech tygodni, zaokrągloną do całych sztuk, i myli się średnio o 12,5 sztuki. Planiści poprawiają ją głównie w górę, „na wszelki wypadek”, i po korektach błąd rośnie do 15,2 sztuki, czyli o 22%. Tyle samo myli się darmowa prognoza naiwna. Według klasycznego wzoru korekty podnoszą zapas bezpieczeństwa tego indeksu mniej więcej o jedną piątą.
To jednak jeden indeks, czyli tylko trop. Rozstrzygnie zakładka „Korekty” z 20 indeksami.
Kiedy test trzeba uzupełnić
Test działa najlepiej dla indeksów, które sprzedają się co tydzień i bez wielkich skoków. Przy sezonowości porównaj się też z sezonową prognozą naiwną, czyli sprzedażą z tego samego tygodnia rok wcześniej. Wklej ją w kopii pliku zamiast swojej prognozy; wymaga roku historii przed testem. Przy rosnącej sprzedaży średnia z czterech tygodni pokazuje poziom sprzed około dwóch i pół tygodnia i zaniża prognozę, więc porównuj się wtedy z wygładzaniem z trendem.
Przy indeksach, które w większości tygodni nie sprzedają się wcale, najmniejszy średni błąd w sztukach może mieć prognoza „zero” [6]. Nikt nie zamówi według niej towaru, więc takie indeksy oceniaj osobno, po zapasie i poziomie obsługi klienta [6]. Policz na przykład, w ilu tygodniach zabrakłoby towaru przy zapasie wyliczonym z każdej prognozy. Przy nowych wyrobach i jednorazowych zdarzeniach, takich jak duże zamówienie albo promocja, darmowe prognozy nie mają historii, a planista ma wiedzę, której system nie zna. Tu korekt nie zakazuj, tylko mierz je osobno.
Trzy pytania do dostawcy, zanim podpiszesz umowę
Pierwsze: z jaką metodą porównywaliście? Prognoza naiwna to łatwy rywal, wygładzanie wykładnicze trudniejszy, a Twoja obecna prognoza to jedyny, który się liczy. Drugie: na jakim poziomie? Wynik dla sumy firmy nic nie mówi o indeksie w magazynie, co pokazał rysunek wyżej. Trzecie: na czyich danych? Poproś o test na około 20 wylosowanych indeksach z Twojej sprzedaży, na poziomie i z wyprzedzeniem, z jakimi zamawiasz.
Na żadne z nich nie odpowiada obietnica, od której zaczęliśmy. Blog polskiej firmy programistycznej Netguru powołuje się na analizę McKinsey Global Institute z 2023 roku. Według niej firmy wdrażające prognozy oparte na sztucznej inteligencji „zmniejszają błąd prognozy o 20–50% w porównaniu z tradycyjnymi statystycznymi punktami odniesienia” [1]. Odnośnika do tej analizy nie ma. Ten sam tekst przyznaje dalej, że dobrze dostrojone metody statystyczne często dorównują gradient boostingowi, jednej z metod uczenia maszynowego, w granicach 1–2 punktów błędu MAPE [1]. Dotyczy to „dojrzałych, szybko zmieniających się SKU” z co najmniej trzyletnią historią czystych danych [1].
Wynik testu wpisz do umowy jako warunek odbioru pilotażu, a próg ustaw nie niżej niż granica remisu dla Twojego wyprzedzenia, bo inaczej system może przejść odbiór przez przypadek. Pilnuj też, by system nie widział sprzedaży z tygodni oceny: przekazuj ją dostawcy tydzień po tygodniu, dopiero gdy dostaniesz od niego prognozy. Przegląd stanu wiedzy o prognozowaniu ostrzega, że dane testowe, miary i metody do porównania bywają dobrane tak, że przesadnie pokazują zalety nowej metody [6]. Zapis może wyglądać jak ten niżej. To przykład liczbowy i propozycja redakcji, a nie wzór umowy, więc brzmienie i próg ustal z prawnikiem.
Ocena obejmuje około 20 indeksów wylosowanych przez Zamawiającego i 26 kolejnych tygodni sprzedaży, na poziomie indeksu w magazynie. Prognozę na każdy z tych tygodni system liczy tylko z danych znanych 4 tygodnie wcześniej, a jego ustawień nie zmienia się w trakcie oceny. Suma błędów bezwzględnych prognoz systemu będzie co najmniej o 15% niższa od sumy błędów obecnej prognozy Zamawiającego i od sumy błędów wygładzania wykładniczego liczonego z tym samym wyprzedzeniem.
Dopisz też koszt utrzymania: licencję, pracę ludzi i obliczenia.
Najpierw zmierz swój proces, potem system dostawcy
Kierownik planowania z początku tekstu wyeksportuje w poniedziałek sprzedaż i prognozy 20 indeksów z ostatnich trzech kwartałów i wklei je do pliku. Sprawdzi, czy jego prognoza bije darmowe, czy korekty planistów pomagają i ile zapasu kosztuje różnica. Z tym wynikiem pójdzie do dostawcy z trzema pytaniami. Tym samym plikiem oceni potem pilotaż: zamiast swojej prognozy wklei prognozę systemu.
Jeśli Twoja prognoza przegrywa z prostymi metodami, zacznij od nich i od korekt, które szkodzą. Nowy system kupuj dopiero wtedy, gdy Twoja prognoza bije proste metody, a system dostawcy w pilotażu wyraźnie bije Twoją.
Pytania i odpowiedzi
Co to jest prognoza naiwna?
To prognoza, w której na następny okres przyjmujesz ostatnią znaną sprzedaż. Nic nie kosztuje i nie wymaga systemu, dlatego służy jako punkt odniesienia: prognoza, która nie myli się mniej niż naiwna, nie poprawia trafności, za którą płacisz czasem planisty albo licencją. Zwykle trudniej pobić średnią z czterech ostatnich tygodni albo wygładzanie wykładnicze.
Jak policzyć błąd prognozy popytu?
Najprościej jako średni błąd bezwzględny (MAE): dla każdego okresu weź różnicę między prognozą a sprzedażą bez znaku i policz średnią w sztukach. Podziel ten błąd przez błąd prognozy naiwnej i lepszej z prostych metod, liczonych z tym samym wyprzedzeniem. Średniego błędu procentowego (MAPE) nie używaj przy indeksach z zerową sprzedażą, bo wtedy nie da się go policzyć.
Czy AI poprawia prognozy popytu?
Zależy od poziomu i danych. W konkursie M5 zwycięska metoda uczenia maszynowego myliła się o 53% mniej niż automatycznie dobierane wygładzanie wykładnicze przy sumie sprzedaży wszystkich sklepów, ale tylko o 3,3% mniej przy pojedynczym produkcie w sklepie. Czy poprawi Twoje prognozy, sprawdzisz tylko na własnych danych.
Co to jest FVA, czyli wartość dodana prognozy?
FVA (forecast value added) mówi, o ile każdy krok procesu prognozowania zmniejsza błąd: na przykład system względem prognozy naiwnej albo korekta planisty względem prognozy systemu. Wynik ujemny oznacza, że krok zwiększył błąd. W badaniach firm korekty planistów poprawiały prognozę w niewiele ponad połowie indeksów, a korekty w górę częściej szkodziły.
Jak prognozować sprzedaż w Excelu?
Excel ma narzędzie Arkusz prognozy (karta Dane, grupa Prognoza), które liczy wygładzanie wykładnicze z trendem i sezonowością. Do sprawdzenia trafności ustaw w Opcjach Początek prognozy przed końcem danych: Excel policzy wtedy prognozę tylko z wcześniejszej sprzedaży. Zanim zaufasz jakiejkolwiek metodzie, porównaj jej błąd z prognozą naiwną i ze średnią z czterech tygodni, z takim wyprzedzeniem, z jakim zamawiasz. Gotowy arkusz z tym porównaniem znajdziesz w materiałach do pobrania.
Źródła
- Rafalski K. (2026), Prognozowanie popytu z AI: dokładniejsze prognozy, blog firmy Netguru (dostawca oprogramowania), 1.06.2026.
- Organizatorzy konkursu M5 (2020), M5 „Accuracy”: Scores and Ranks, plik wyników (arkusze Accuracy-Benchmarks i Accuracy-Top50), repozytorium Mcompetitions/M5-methods. Przewagę według poziomów policzyła redakcja.
- Fildes R., Goodwin P., De Baets S. (2025), Forecast value added in demand planning, International Journal of Forecasting, 41(2), 649–669 (według streszczenia autorów).
- Makridakis S., Spiliotis E., Assimakopoulos V. (2022), M5 accuracy competition: Results, findings, and conclusions, International Journal of Forecasting, 38(4), 1346–1364 (cytujemy według wersji roboczej z 2020 r.).
- Theodorou E., Wang S., Kang Y., Spiliotis E., Makridakis S., Assimakopoulos V. (2022), Exploring the representativeness of the M5 competition data, International Journal of Forecasting, 38(4), 1500–1506 (cytujemy według wersji arXiv:2103.02941).
- Petropoulos F. i in. (2022), Forecasting: theory and practice, International Journal of Forecasting, 38(3), 705–871, rozdz. 2.12, 3.1, 3.2.2 i 3.2.3.
- Spiliotis E., Makridakis S., Semenoglou A.-A., Assimakopoulos V. (2022), Comparison of statistical and machine learning methods for daily SKU demand forecasting, Operational Research, 22(3), 3037–3061 (według streszczenia autorów).
- Fildes R., Goodwin P., Lawrence M., Nikolopoulos K. (2009), Effective forecasting and judgmental adjustments: an empirical evaluation and strategies for improvement in supply-chain planning, International Journal of Forecasting, 25(1), 3–23 (według streszczenia autorów).
- Microsoft (2026), Tworzenie prognozy w programie Excel dla systemu Windows, pomoc techniczna Microsoft (Excel dla Microsoft 365, 2024 i 2021).
- Hyndman R. J., Koehler A. B. (2006), Another look at measures of forecast accuracy, International Journal of Forecasting, 22(4), 679–688.
- Fildes R., Goodwin P. (2007), Against your better judgment? How organizations can improve their use of management judgment in forecasting, Interfaces, 37(6), 570–576 (według wersji roboczej, Lancaster University Management School Working Paper 2007/005).